

产品中心
|
U3156
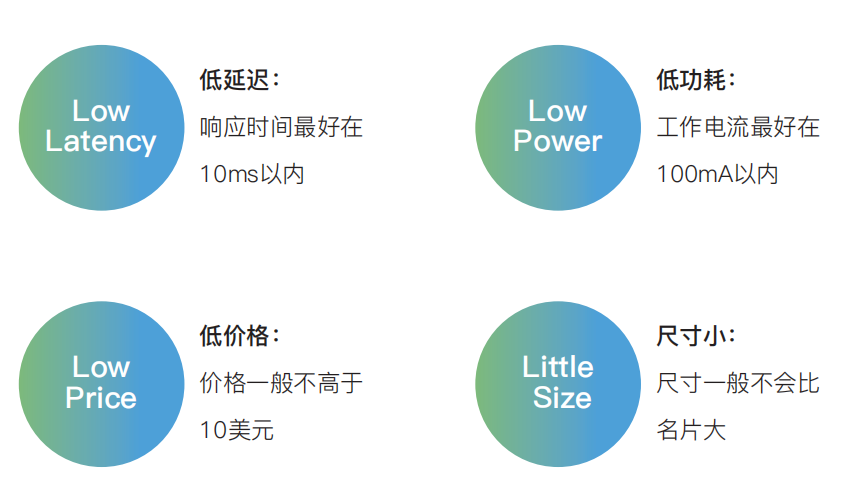
2025年8月,优象新一代智能芯片U31研制成功。能同时完成两路视频、8路音频信号的智能处理,是一款能够充分满足“4L” 要求(Low Latency、Low Power、Low Price、Little Size)的Edge AI芯片。 Edge AI的行业痛点可归纳为“4L”:Low Latency、Low Power、Low Price、Little Size。Low Latency(低延迟)强调需要快速响应,响应时间最好能够控制在10ms以内。Low Power(低功耗)与产品的散热问题紧密相关,工作电流最好控制在100mA以内。Low Price(低价格)是Edge AI产品的一个典型需要,作为机器人或无人机的智能感知部件,一台设备可能不止部署一套,比如扫地机避障,可能需要四个面分别部署一套,只有控制价格才能大量推广应用。价格最好不超过10美元。尺寸小是Edge AI产品必须具备的一项功能,尺寸最好不超过名片大小。
优象研发人员在总结30年视音频处理算法研究经验的基础上,自定义了一套指令集,既包含32位通用指令、部分64位通用指令,还包含了神经网络计算、LK光流、ORB特征、双目立体匹配以及FFT/IFFT等专用指令。极大地提高了音视频算法实时处理效率,降低了功耗,减少了芯片面积。
除了为了Edge AI定制的指令集之外,U31还创新性地设计了五大加速机制,以确保U31能够满足Edge AI的“4L”要求。 一、WDMA(Windowing DMA)技术。通过二维开窗DMA技术,可以灵活且快速地从PSRAM或SRAM中读取图像块或矩阵数据到寄存器中。在读取数据到寄存器的同时,支持下列硬件加速功能: Ø 支持图像裁剪、缩放和双线性插值; Ø 支持图像膨胀/腐蚀计算; Ø 支持图像2*2、3*3、5*5和7*7的双通道卷积滤波计算; Ø 支持FAST特征点检测加速; Ø 支持矩阵乘法计算加速; Ø 支持神经网络计算加速。 二、寄存器自动映射RA(Register Automapping)技术:能够把128位寄存器自动映射为4个32位或2个64位寄存器。在RA机制支持下,可以在单cycle内读取128位数据到一个128位寄存器中,这个128位寄存器可以被自动映射为4个32位寄存器,这4个32位寄存器可独立参与不同指令的计算,计算完成后在单cycle内把128位寄存器写入RAM中。RA可把数据读写的效率提高4倍。 三、流式管线SP(Streaming Pipeline):在流式管线SP支持下,流媒体数据的当前帧被处理的同时,CPU并行地在后台把下一帧数据读取到寄存器中,数据读取和数据处理完全并行,大大地提高了像视音频这样的流媒体处理效率。 四、SIMD(Single Instruction Multiple Data):可实现单cycle内执行4次32位浮点MAC计算,或4次32位定点MAC计算,或8次16位定点MAC计算。 五、向量计算(Vector Computing):基于VLIW(Very-Long-Instruction-Width,超长指令字)技术实现了一种向量计算,把需要多次重复执行的指令打包成一个96位的超长指令,每个指令包含指令码、数据起始地址、数据终止地址、数据格式以及各种操作标志等。指令只需要读一次,可计算多达2047个数据,避免了在计算时多次读取指令和解码指令的开销,极大地提高了执行效率。 |